IA en entreprise
Pilote IA en entreprise : comment mesurer les gains dans le travail réel ?
Un pilote n’est pas concluant parce que l’outil fonctionne ou que les comptes sont actifs. Il faut vérifier la charge qu’il supprime réellement, celle qu’il déplace vers d’autres personnes et celle qu’il crée en imposant des contrôles ou des reprises. Trois mesures doivent être analysées ensemble : l’usage effectif de l’outil pour la tâche prévue, la qualité des sorties appréciée par leur destinataire et la charge de travail totale, contrôles compris. L’observation doit commencer avant le premier test, faute de quoi aucun gain ne pourra être attribué à l’IA.
01Mesurer le travail avant de lancer le pilote
L’observation porte sur la tâche complète, pas sur l’outil ni sur les comptes activés. Elle commence par l’information qui déclenche le travail et se termine lorsque le résultat peut effectivement être utilisé. Entre les deux se trouvent des recherches, des arbitrages, des contrôles, des échanges et des corrections souvent absents de la description officielle du processus.
Avant le pilote, les personnes qui réalisent la tâche et celles qui en utilisent le résultat décrivent cette chaîne. Elles précisent les cas ordinaires, les exceptions, les informations manquantes, les validations attendues et les signes qui les conduisent à douter d’un résultat. Il ne s’agit pas de figer toutes les pratiques, mais d’obtenir un point de départ assez précis pour reconnaître ensuite un gain, une perte ou un déplacement de charge.
La production visible ne suffit pas. Un texte, un classement ou un dossier prérempli peut être produit plus vite, tandis que le temps consacré à retrouver la source, contrôler une formulation, corriger une catégorie ou ressaisir une donnée augmente. Pour éviter ce bilan trompeur, l’observation distingue six registres.
-
Registre 1
Production
Quel résultat exploitable la personne doit-elle obtenir, et à partir de quelle information reçue ?
-
Registre 2
Vérification
Que faut-il relire, recouper ou faire valider avant que le résultat puisse être utilisé ?
-
Registre 3
Reprise
Quelle partie doit être corrigée ou recommencée, et par qui ?
-
Registre 4
Contournement
Quelle autre méthode est employée lorsque l’outil gêne, échoue ou arrive trop tard ?
-
Registre 5
Coordination
Qui faut-il solliciter pour terminer la tâche, et combien de fois ?
-
Registre 6
Jugement métier
Quelle compétence demeure nécessaire pour décider, et qui la détient réellement ?
Il faut distinguer le parcours prévu du parcours réellement suivi. Copier une sortie dans un autre outil, maintenir une procédure parallèle ou solliciter systématiquement un collègue fait partie du travail. Omettre ces gestes reviendrait à attribuer à l’IA un gain qui provient en réalité d’un déplacement de charge au sein de l’organisation.
Le point de départ comprend aussi un résultat de référence. L’équipe précise ce qu’un résultat acceptable permet de faire, qui l’utilise et dans quelles conditions il doit être repris. Une tâche peut sembler achevée pour l’utilisateur de l’outil tout en restant inutilisable pour son destinataire. La mesure va donc jusqu’au moment où le travail produit effectivement l’effet attendu. Les référentiels de conception des services publics expriment le même principe : résoudre l’ensemble du problème de l’usager, et non le seul segment confié à l’équipe.[8]
Le profil du NIST consacré à l’IA générative recommande d’évaluer les performances en situation d’usage réel, afin d’observer le comportement pratique du système et de révéler des difficultés absentes des essais contrôlés.[1] Cette recommandation conduit à observer l’outil pendant le travail, plutôt qu’à se contenter d’une démonstration en salle.
Avant le premier test, observez une tâche complète du début à la fin. Consignez séparément le résultat produit, les vérifications, les reprises et les contournements ; sans ce relevé initial, un gain apparent restera impossible à attribuer à l’IA.
02Former à l’outil ne suffit pas
L’adoption se prépare dès le choix de la tâche. Il faut reporter un cas d’usage s’il suppose des données indisponibles, une vigilance impossible à maintenir ou une compétence que personne ne peut mobiliser au moment nécessaire. Le pilote sert précisément à vérifier ces conditions avant de décider d’une éventuelle généralisation.
La vigilance est la condition la plus souvent supposée acquise. Les travaux d’ergonomie industrielle l’établissent depuis longtemps : la détection d’anomalies rares ne peut reposer uniquement sur l’attention humaine ; elle doit être appuyée par une alarme automatique.[5] Demander à une personne de surveiller en continu des sorties presque toujours correctes n’est donc pas une simple règle d’usage : c’est une charge à mesurer pendant le pilote.
Les personnes concernées ne se limitent pas aux futurs utilisateurs directs. Il faut également identifier celles qui fournissent les informations, reçoivent les résultats, corrigent les erreurs, traitent les exceptions ou subissent les conséquences d’une mauvaise décision. Leur participation dépend de l’effet concret du cas d’usage sur leur activité, pas de leur place dans l’organigramme. Le cadre de gestion du risque du NIST prévoit d’associer les experts métier, les utilisateurs, des acteurs extérieurs à l’équipe ayant développé ou déployé le système, et les communautés affectées lorsque la tolérance au risque de l’organisation le justifie.[2]
Chacune apporte une connaissance particulière de la tâche.
-
Regard 1
L’utilisateur
Sait reconnaître une entrée atypique ou une sortie difficile à utiliser.
-
Regard 2
Le destinataire
Sait dire si le résultat permet réellement d’agir.
-
Regard 3
L’expert métier
Peut détecter une incohérence que l’outil et l’utilisateur novice laisseraient passer.
Ces apports servent à définir ce qui peut être accepté, ce qui doit être vérifié et les cas dans lesquels l’usage doit être interrompu. Les référentiels de conception des services publics recommandent de partir des usagers et du problème qu’ils cherchent à résoudre, plutôt que d’une solution particulière.[7]
La préparation porte ensuite sur les compétences nécessaires.
-
01
Formuler une demande exploitable
La personne sait décrire la tâche, ses contraintes et le format attendu.
-
02
Retrouver une source
Elle sait d’où vient l’information et comment la vérifier.
-
03
Repérer une incohérence
Elle reconnaît une sortie plausible mais fausse.
-
04
Corriger le résultat
Elle sait quoi reprendre, et jusqu’où.
-
05
Reprendre la main
Elle peut revenir au processus habituel sans attendre une autorisation.
Si une compétence manque, il faut prévoir comment la renforcer ou adapter le contrôle avant de poursuivre le test. Une démonstration de l’outil ne répond pas à ce besoin, car elle ne vérifie pas la capacité à agir dans un cas réel.
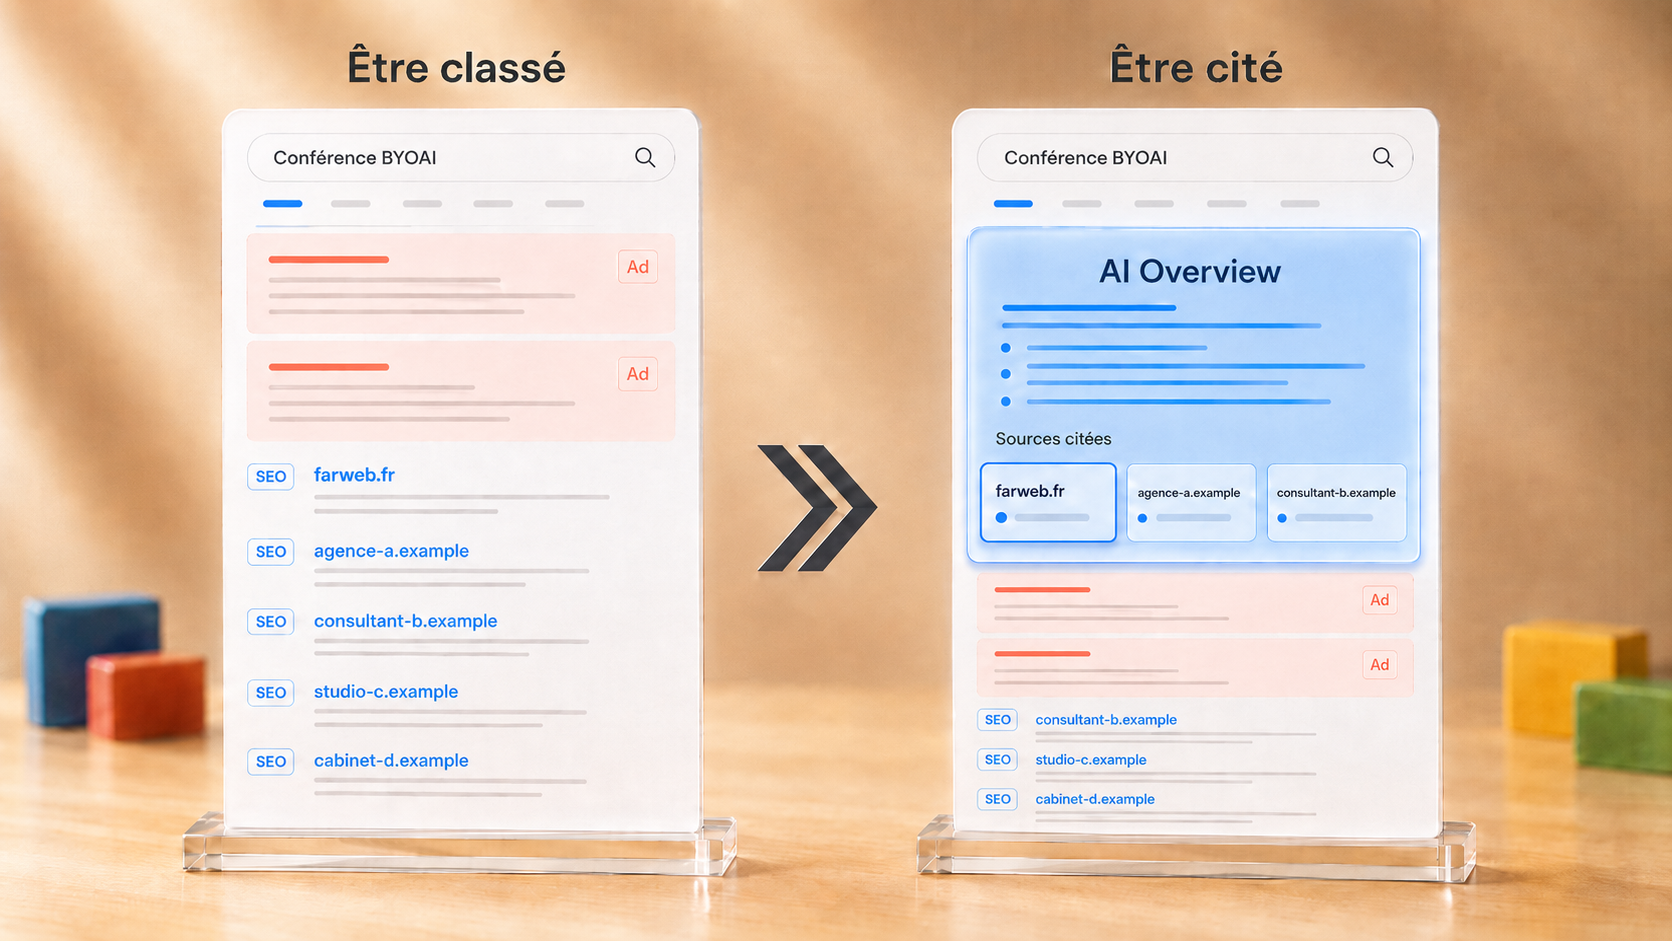
Lorsque le premier obstacle tient à l’absence de repères communs sur les usages et les risques, une conférence BYOAI peut aider à les établir ; elle ne remplace ni l’observation des tâches ni la mesure du pilote.
Les règles doivent rester accessibles au moment où la personne utilise l’outil. Elles précisent la tâche testée, les entrées admises, les contrôles obligatoires, les sorties inutilisables et le canal de retour. Elles peuvent évoluer lorsqu’un cas imprévu apparaît, à condition que la modification soit datée et prise en compte dans l’analyse des résultats.
Cette préparation ne remplace ni la qualification juridique du système ni l’attribution formelle des responsabilités de contrôle. Ces sujets relèvent d’un travail distinct : lorsque des données personnelles sont utilisées pendant le test, la finalité doit être définie dès la conception.[13] L’entreprise doit aussi déterminer quelles responsabilités lui incombent au regard du RGPD.[13] La question traitée ici est plus précise : l’équipe peut-elle accomplir la tâche avec les données, les compétences et les règles d’usage disponibles ?
03Comparer le gain ressenti au temps réellement mesuré
Pendant le test, chaque retour doit être rattaché à un cas identifiable. Une impression globale recueillie en fin de période ne permet pas de savoir quand une vérification supplémentaire, un ralentissement ou un contournement s’est produit. Une note utile indique l’entrée reçue, l’action attendue, la sortie obtenue, la décision prise et le travail ajouté pour terminer la tâche.
Ce relevé n’a pas besoin d’être long. Il doit être assez précis pour comprendre l’écart sans transformer chaque utilisateur en analyste du projet. Il consigne la date, le type de tâche, la conséquence de la sortie et l’action corrective, afin que chaque observation puisse être replacée dans son contexte.
Les erreurs se classent selon leur effet sur le travail. Certaines rendent immédiatement la sortie inutilisable. D’autres semblent mineures mais imposent une relecture intégrale, car personne ne sait où se trouve le défaut. D’autres encore déplacent la correction vers le destinataire. Le nombre d’erreurs ne décrit donc pas, à lui seul, la charge créée.
Le contournement apporte une information différente. Une personne peut ouvrir régulièrement l’outil tout en préparant les entrées ailleurs, en reconstruisant la sortie ou en conservant l’ancienne méthode comme sécurité. Une connexion régulière prouve seulement que l’outil a été ouvert ; elle ne démontre pas qu’il améliore la tâche. Il faut décrire ce parcours parallèle, puis en discuter avec la personne concernée pour en comprendre la cause.
L’écart le mieux documenté à ce jour concerne la perception du gain plutôt que le gain lui-même.
METR, essai contrôlé randomisé[3]
- Échantillon
- 16 développeurs expérimentés, 246 tâches réelles sur leurs propres dépôts
- Période
- 2025
- Résultat
- 19 % de temps supplémentaire avec les outils d’IA. Après l’essai, ces mêmes personnes estimaient pourtant avoir travaillé 20 % plus vite, alors qu’avant de commencer, elles attendaient un gain de 24 %.
- Limite de lecture
- L’étude porte sur des développeurs très expérimentés travaillant sur du code qu’ils connaissent. Les auteurs écartent eux-mêmes toute généralisation à l’ensemble du développement.
Morten Hertzum, revue méta-analytique du Task Load Index[6]
- Échantillon
- 556 études de charge de travail auto-déclarée
- Période
- 2021
- Résultat
- 35 à 56 de score moyen selon le domaine, sur une échelle de 100. Les scores sont plus élevés pour l’exigence mentale et l’effort, plus faibles pour l’exigence physique et la frustration.
- Limite de lecture
- Une valeur de référence sert à situer une mesure, mais ne suffit jamais à décider : elle ne dit pas si la charge observée est acceptable dans votre organisation.
Les réserves formulées par les auteurs doivent être conservées. En février 2026, METR a estimé que le refus de participer de développeurs ne souhaitant pas travailler sans IA avait probablement conduit à sous-estimer le gain.[4] L’équipe estime que ses données récentes n’apportent qu’un niveau de preuve très faible quant à l’ampleur de ce gain.[4] Elle a donc engagé une modification de son protocole.[4] Ce résultat ne dit pas que l’IA ralentit le travail. Il montre seulement qu’une conviction de gain, même partagée par des professionnels expérimentés, ne remplace pas une mesure.
Deux enseignements en découlent. Le premier est qu’une déclaration de gain ne peut pas tenir lieu de mesure, y compris venant de professionnels expérimentés et de bonne foi. Le second est qu’un instrument de mesure de la charge fournit des repères comparables, à condition de relever séparément l’exigence mentale, l’effort et la frustration, au lieu de tout réunir dans une appréciation unique.
Les retours servent d’abord à corriger le pilote. Une difficulté récurrente peut conduire à modifier la tâche confiée, la qualité des entrées, la règle d’usage ou le périmètre. Si cette modification transforme profondément le cas d’usage, le bilan doit le signaler : la nouvelle version n’hérite pas automatiquement des résultats favorables de la précédente.
Le retrait d’un utilisateur constitue lui aussi une donnée. Il peut révéler une sortie peu utile, une vérification trop coûteuse, un outil accessible au mauvais moment du processus ou une incompatibilité avec certains cas. Il peut également avoir une cause extérieure au pilote. Un échange centré sur la tâche permet de distinguer ces explications sans exclure cette personne de l’évaluation.
Un questionnaire isolé n’établit pas l’adoption. Une appréciation positive ou négative ne prend tout son sens qu’en la comparant aux sorties obtenues, aux corrections réalisées et aux opérations supplémentaires observées. Les déclarations et les traces de travail se complètent ; aucune ne doit servir à invalider automatiquement l’autre.
Enfin, l’analyse conserve les différences entre métiers et contextes. Un outil utile dans les cas réguliers peut devenir encombrant face aux exceptions. La bonne décision consiste parfois à limiter son périmètre, plutôt qu’à généraliser un usage qui ne tient que dans une partie de l’activité.
04Évaluer ensemble l’usage, la qualité et la charge de travail
La décision ne repose pas sur un indicateur unique. Le nombre de comptes, de sessions ou de sorties décrit une activité, mais ne dit pas si la charge totale diminue, si le résultat reste exploitable ou si les corrections sont transférées à d’autres personnes. Le bilan réunit donc trois mesures portant sur la même tâche.
L’usage effectif montre les cas dans lesquels l’outil est sollicité, délaissé ou doublé par une procédure parallèle. La qualité des sorties distingue l’acceptation en l’état, la correction limitée, le rejet et la reprise complète. La mesure de la charge reprend les six registres relevés au départ : production, vérification, reprise, contournement, coordination et jugement métier.
Il est essentiel de conserver les mêmes registres. Une correction rapide et une vérification exhaustive peuvent toutes deux aboutir à un résultat utilisable, sans demander la même charge de travail. De même, un gain pour la personne qui produit la sortie peut être annulé par une charge supplémentaire imposée à son destinataire.
Ces mesures servent à trancher des questions précises, sans être ramenées à une note unique valable dans tous les cas.
| Dimension observée | Signal relevé | Question à trancher |
|---|---|---|
| Usage effectif | L’outil est sollicité sur la tâche prévue | Intervient-il sur l’ensemble des cas, ou seulement sur les plus faciles ? |
| Usage effectif | Un parcours parallèle subsiste | Révèle-t-il une difficulté qui peut être corrigée ou une incompatibilité durable ? |
| Qualité des sorties | Le destinataire agit sans correction | Peut-il le faire sans contrôle disproportionné ni compétence rare ? |
| Qualité des sorties | Une reprise reste nécessaire | Après correction, ce que l’outil a produit reste-t-il utile ? |
| Charge de travail | La vérification reste nécessaire | Peut-on lever le doute au prix d’un effort soutenable, avec les compétences disponibles ? |
| Charge de travail | La coordination augmente | Le travail a-t-il été supprimé, ou seulement déplacé vers d’autres personnes ? |
Les critères doivent être définis avant le bilan, et non reconstruits ensuite pour justifier le résultat. La poursuite se justifie lorsque l’outil intervient bien sur la tâche prévue, produit une sortie exploitable et n’ajoute pas une charge disproportionnée. Le pilote doit être ajusté lorsqu’un obstacle précis peut être corrigé sans changer la finalité du cas d’usage. Il faut pivoter lorsque l’observation montre que l’outil est surtout utile à une autre étape du processus.
À la fin du pilote, quatre décisions sont possibles, chacune assortie d’une condition et d’une suite.
| Décision | Quand la prendre | Suite |
|---|---|---|
| Poursuivre | La sortie est exploitable et les vérifications, reprises et contournements restent soutenables. | Conserver le périmètre et suivre les mêmes mesures. |
| Ajuster | L’utilité de l’outil est confirmée, mais une donnée d’entrée, une règle ou un contrôle doit être modifié. | Tester la correction avant toute extension. |
| Pivoter | L’outil est utile à une autre étape que celle prévue, ou seulement à une partie de la tâche. | Redéfinir le cas d’usage et établir un nouveau point de comparaison. |
| Arrêter | Les contrôles, reprises ou contournements ajoutent durablement plus de travail que l’outil n’en retire. | Mettre fin au test et conserver les raisons de la décision. |
Une réussite technique ne compense pas une dégradation durable du travail. Arrêter dans ce cas ne transforme pas le pilote en échec collectif : le test a rempli sa fonction en évitant une généralisation qui aurait transféré les coûts et les erreurs à d’autres personnes sans améliorer la tâche.
05Les taux d’adoption de l’IA ne prouvent aucun gain
Le bilan reprend la même tâche et les mêmes registres qu’au départ. Il confronte le parcours initial au parcours observé, y compris les exceptions, les abandons et les tâches reportées sur d’autres personnes. La conclusion indique où le travail a diminué, où il s’est déplacé et quelles incertitudes subsistent.
Les faits observés restent séparés des hypothèses. Une amélioration limitée à certains cas ne justifie qu’un périmètre limité. Une compétence encore absente devient une condition de poursuite. Si une règle est souvent contournée, il faut revoir le cas d’usage ou sa place dans le processus.
Cette exigence n’est pas excessive, compte tenu de ce que les organisations savent réellement de leurs propres systèmes.
Une organisation qui ignore qui accède à quoi ne saura pas davantage dire qui a corrigé quoi.
La décision précise ce qui sera conservé ou revu : la tâche retenue, les personnes concernées, les règles d’usage, la préparation nécessaire, les modalités de retour et les signaux qui déclencheront un réexamen. Sans cette continuité, l’étape suivante efface les conditions qui rendaient le résultat acceptable.
Après un pivot, il faut établir un nouveau point de comparaison pour la partie modifiée. Après un ajustement local, l’observation vérifie que la correction réduit effectivement la difficulté identifiée. Après un arrêt, le dossier conserve les conditions d’incompatibilité, afin d’éviter de relancer plus tard le même cas sous un autre nom.
La pression à généraliser reste forte et mérite d’être remise à sa place. En 2025, 19,95 % des entreprises de l’Union européenne déclaraient utiliser au moins une technologie d’intelligence artificielle, contre 55,03 % des grandes entreprises.[9] Dans le secteur public britannique, 70 % des organismes interrogés par le National Audit Office expérimentaient ou planifiaient des cas d’usage.[11] Ces chiffres portent sur des usages et des intentions déclarés, pas sur un allègement du travail. Le guide d’usage de l’IA publié par le gouvernement britannique prévient d’ailleurs que l’IA peut ne pas être la meilleure solution au problème posé et qu’une technologie éprouvée peut parfois mieux le résoudre.[10]
Un outil aide réellement une équipe lorsque l’exécution complète de la tâche aboutit à un résultat exploitable avec une charge de travail mieux maîtrisée. Il ne fait que déplacer le travail si la sortie est produite plus vite, mais que la vérification, la reprise ou la coordination absorbent durablement ce gain.
La règle finale doit pouvoir être appliquée sans redéfinir les critères après coup : poursuivre lorsque l’exécution complète de la tâche aboutit à un résultat exploitable avec une charge soutenable ; ajuster lorsqu’une difficulté localisée peut être corrigée sans modifier l’hypothèse testée ; pivoter lorsque le besoin reste valable mais que la tâche ou le protocole doit changer ; arrêter lorsque le contrôle, les reprises ou les contournements annulent durablement le gain attendu.
Questions fréquentes
Un pilote IA utilisé par toute l’équipe est-il forcément réussi ?
Que faut-il mesurer avant de lancer un pilote IA ?
Le ressenti des utilisateurs suffit-il pour mesurer le gain ?
Une formation à l’outil peut-elle corriger un pilote qui fonctionne mal ?
Comment compter le temps de contrôle et de correction des sorties ?
Une faible adoption signifie-t-elle que les équipes refusent l’IA ?
Une conférence peut-elle préparer l’adoption d’un pilote IA ?
Quand faut-il faire auditer un pilote IA avant de le généraliser ?
Sources consultées
- National Institute of Standards and Technology · « Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1) » · 26 juillet 2024 · nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf.
- National Institute of Standards and Technology · « Artificial Intelligence Risk Management Framework (AI RMF 1.0) » · 26 janvier 2023 · nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf.
- Joel Becker, Nate Rush, Elizabeth Barnes, David Rein (METR) · « Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity » · 10 juillet 2025 · metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study.
- METR · « We are Changing our Developer Productivity Experiment Design » · 24 février 2026 · metr.org/blog/2026-02-24-uplift-update.
- Lisanne Bainbridge, University College London · « Ironies of automation, Automatica, vol. 19, n° 6, p. 775-779 » · 1983 · web.archive.org/web/20200717054958if_/https://www.ise.ncsu.edu/wp-con….
- Morten Hertzum, université de Copenhague · « Reference Values and Subscale Patterns for the Task Load Index (TLX): A Meta-Analytic Review, Ergonomics, vol. 64, n° 7, p. 869-878 » · 2021 · mortenhertzum.dk/publ/ERGONOMICS2021.pdf.
- Government Digital Service · « Understand users and their needs » · 8 mai 2019, mise à jour le 30 mai 2022 · www.gov.uk/service-manual/service-standard/point-1-understand-user-needs.
- Government Digital Service · « Solve a whole problem for users » · 8 mai 2019, mise à jour le 29 janvier 2026 · www.gov.uk/service-manual/service-standard/point-2-solve-a-whole-problem.
- Eurostat · « Use of artificial intelligence in enterprises » · décembre 2025 · ec.europa.eu/eurostat/statistics-explained/index.php?title=Use_of_art….
- Gouvernement britannique · « Artificial Intelligence Playbook for the UK Government » · 10 février 2025 · www.gov.uk/government/publications/ai-playbook-for-the-uk-government/….
- National Audit Office · « Use of artificial intelligence in government » · 15 mars 2024 · www.nao.org.uk/reports/use-of-artificial-intelligence-in-government.
- Netherlands Court of Audit · « An Audit of 9 Algorithms used by the Dutch Government » · 18 mai 2022 · english.rekenkamer.nl/publications/reports/2022/05/18/an-audit-of-9-a….
- CNIL · « Développement des systèmes d’IA : les recommandations de la CNIL pour respecter le RGPD » · 22 juillet 2025 · www.cnil.fr/fr/developpement-des-systemes-dia-les-recommandations-de-….
Mesurer la tâche, pas l’outil
Préparer l’observation de votre pilote avant son lancement
Lors d’un premier échange, je définis avec vous la tâche à observer, les six dimensions à relever séparément et le point de comparaison. Vous repartez avec un relevé qui distingue le gain réel du travail simplement déplacé.
Cet échange porte sur la méthode d’observation et la décision qu’elle prépare ; il ne comprend ni le paramétrage de l’outil ni la formation des équipes ni la conduite du pilote.